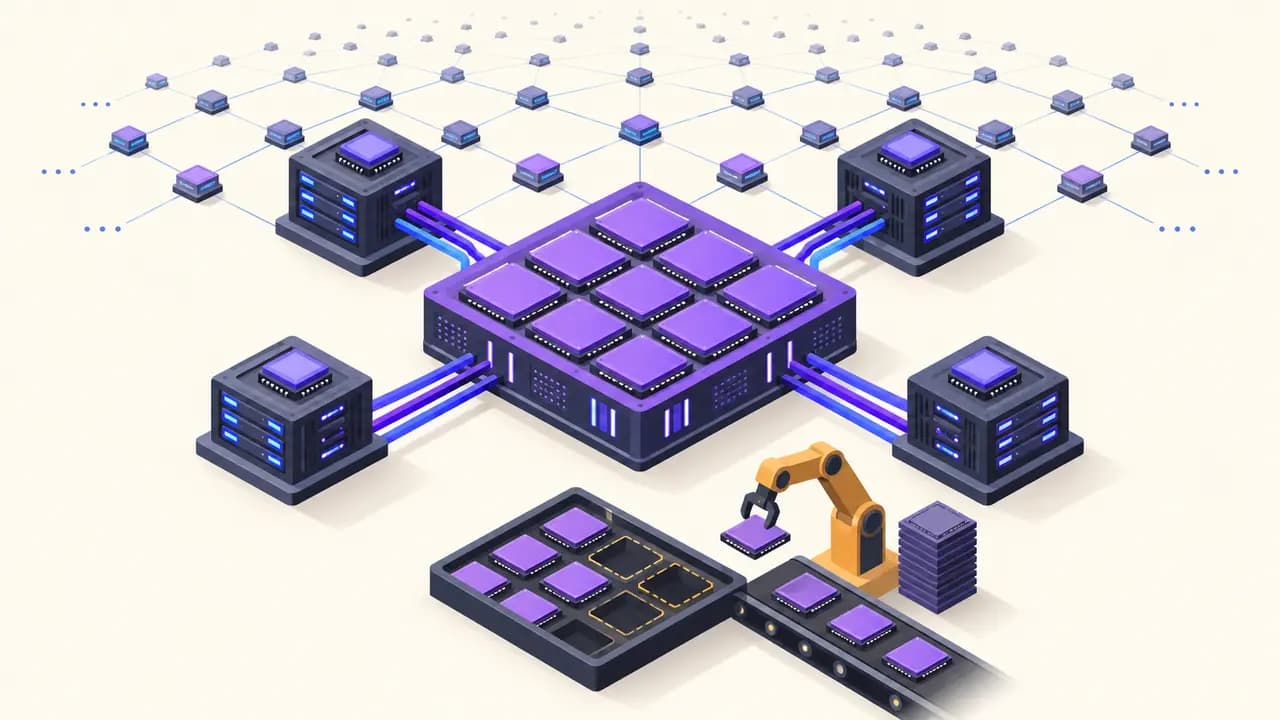
Kurzfassung: Huawei will den Ascend 960DT im ersten Quartal 2027 fertigstellen – drei Quartale früher als bisher geplant. Die neue Peerium-Architektur soll langfristig bis zu eine Million Prozessoren verbinden. Der Fahrplan ist ambitioniert, doch Huaweis eigener Kapazitätsengpass und fehlende unabhängige Effizienzdaten begrenzen seine Aussagekraft.
Vorgezogener Chip-Fahrplan
Auf der Huawei Connect in Shanghai kündigte das Unternehmen den Ascend 960DT für das erste Quartal 2027 und den 960PR für das dritte Quartal an. Damit liegen beide Termine vor dem bisherigen Plan. Ascend 970 und 980 sollen 2028 beziehungsweise 2029 folgen. Huawei erklärte zugleich, nicht genug KI-Rechentechnik für die chinesische Nachfrage produzieren zu können; eine breite internationale Expansion sei deshalb nicht vorgesehen.
Ein Ascend-960-Supernode soll bis zu 4.096 KI-Prozessoren koppeln. Mehrere Nodes sollen Cluster mit Hunderttausenden Prozessoren bilden; Peerium ist für eine maximale Ausbaustufe von einer Million ausgelegt. UnifiedBus verbindet dabei Prozessoren, Speicher und Netzwerkkomponenten. Diese Linie setzt die 2025 angekündigten Atlas-Supercluster fort, für die Huawei bereits mehr als eine Million Ascend-NPUs in Aussicht gestellt hatte.
Huawei begründet die Systemstrategie mit der Kommunikation: In herkömmlichen Serverclustern könne sie bei großen Trainingsläufen mehr als 40 Prozent der Zeit beanspruchen. Auch diese Zahl ist eine Herstellerangabe. Technische Daten zu Leistungsaufnahme, Verfügbarkeit, Fehlertoleranz und nutzbarer Bandbreite der neuen Peerium-Ausbaustufen liegen bislang nicht öffentlich vor.
Pandorex Analyse
Der beschleunigte 960-Fahrplan und der Ausbau des Interconnects passen zu Huaweis bekannten Fertigungsgrenzen: Wenn einzelne Beschleuniger hinter westlichen Spitzenchips zurückliegen, kann eine eng gekoppelte Systemarchitektur einen Teil des Nachteils ausgleichen. Das belegt jedoch keine Leistungsführerschaft. Mit wachsender Clustergröße steigen auch Energiebedarf, Netzwerkkomplexität und Ausfallwahrscheinlichkeit; eine Million adressierbare Prozessoren ist nicht automatisch eine effizient nutzbare Million.
Auch das Software-Ökosystem bleibt ein Engpass. Huawei nennt mehr als 5.200 monatlich aktive Ascend-Entwickler und über 40 direkt auf der Plattform trainierte Modelle, während Nvidia mit CUDA über eine deutlich breitere installierte Basis verfügt. Der belastbarste neue Befund ist daher nicht der Maximalwert, sondern die Kombination aus vorgezogenem Silizium, stärkerer Systemintegration und gleichzeitig offen eingeräumter Lieferknappheit.