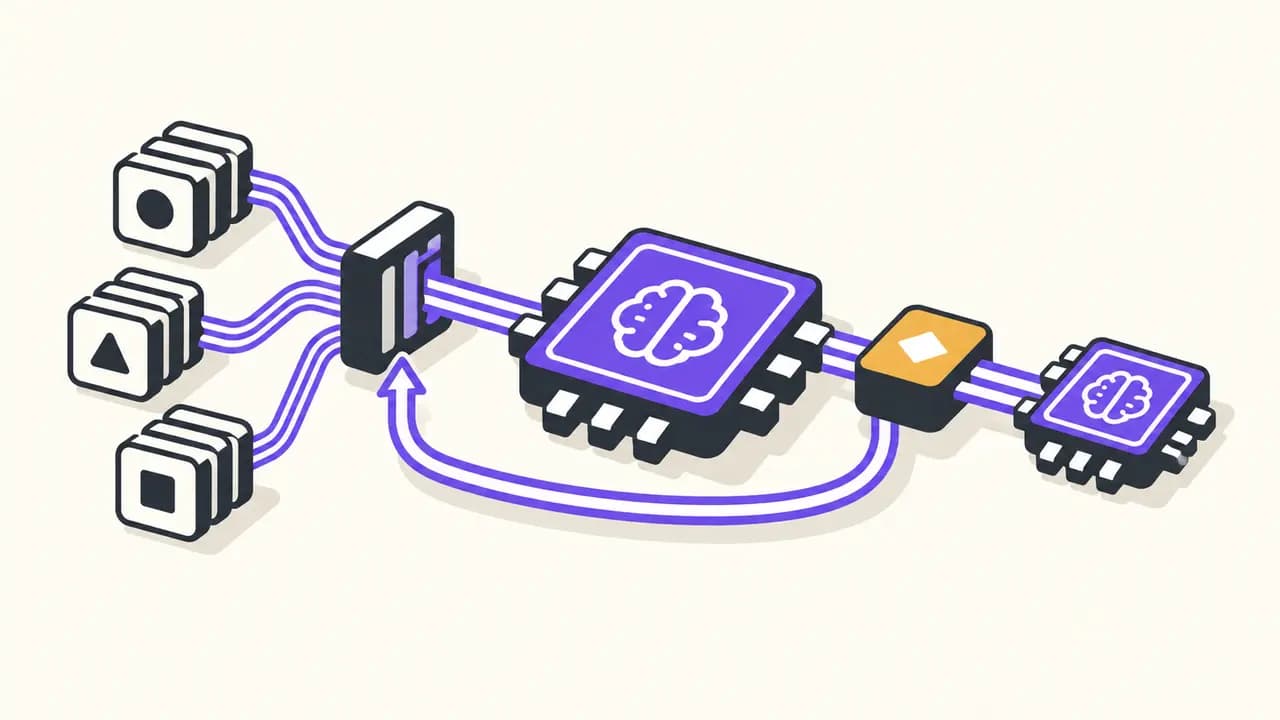
IBM beschreibt einen LLM-Schutzfilter, der aus realen Produktionsdaten lernen soll. Die am 10. September 2026 veröffentlichte US-Anmeldung US20260268157A1 verbindet Clustering, gezielte Annotation und wiederholtes Nachtraining. Ein Benchmark entscheidet anschließend, ob ein kompaktes Update destilliert wird.
Vom kleinen Startdatensatz zum laufenden Rückkopplungsprozess
Zunächst trainiert das Verfahren einen Klassifikator mit einem beschrifteten Startdatensatz. Als Beispiel nennt IBM einen Filter, der Gesundheitsratschläge in LLM-Ein- oder -Ausgaben erkennt. Der Klassifikator sucht danach in noch unbeschrifteten Produktionsdaten nach positiven Treffern und gruppiert deren Einbettungen in Cluster.
Statt jeden Treffer einzeln zu prüfen, kann das System den Mittelpunkt oder einen zufällig gewählten Datensatz pro Cluster annotieren und die Kennzeichnung auf die übrigen Punkte übertragen. Mit diesen Labels wird der Klassifikator nachtrainiert, gespeichert und erneut gegen einen kuratierten Datensatz getestet. Ansprüche 1–7 decken diesen Kreislauf aus Auswahl, Clustering, Annotation, Feinabstimmung und Benchmark-Vergleich ab.
Sinkt die gemessene Leistung unter einen Grenzwert, sieht die Anmeldung einen zusätzlichen Schritt vor: Aus aktuellen und früheren Produktionsdaten werden gleich große Stichproben gezogen. Der aktuelle und der vorherige Modellstand erzeugen dafür weiche Klassenwahrscheinlichkeiten. Ein kleineres Modell soll beide Wissensstände übernehmen und den aktuellen Checkpoint ersetzen. Die Beschreibung nennt dafür beispielhaft eine statistisch signifikante Verschlechterung; sie legt aber keinen festen Produktgrenzwert fest.
Pandorex Einschätzung: Weniger Handarbeit, neue Fehlerquelle
Der praktische Reiz liegt in der Skalierung: Teams könnten einen schmalen, domänenspezifischen Schutzfilter mit echten Nutzungsmustern erweitern, ohne sämtliche Produktionsbeispiele manuell zu beschriften. Der Rückgriff auf frühere Checkpoints soll zugleich verhindern, dass eine neue Datenwelle bereits gelernte Fälle verdrängt.
Die Abkürzung über Cluster bleibt jedoch riskant. Eine falsche Kennzeichnung am ausgewählten Punkt kann auf einen ganzen Cluster übergehen; seltene oder vom ersten Klassifikator übersehene Fälle gelangen womöglich nie in den Lernprozess. Die geprüfte Anmeldung enthält keinen Vergleichsbenchmark, der Genauigkeit, Fehlalarme, Rechenkosten oder Datenschutzfolgen in einem Produktbetrieb belegt.
Dokumentstand, geprüft am 13. September: veröffentlichte US-Patentanmeldung von International Business Machines Corporation, eingereicht am 7. März 2025 unter 19/073,433. Genannt sind Anna Lisa Gentile, Kellen Cheng und Chad Eric DeLuca. Die A1-Veröffentlichung ist weder eine Patenterteilung noch ein Nachweis, dass IBM das Verfahren in einem Produkt einsetzt.